Pamięć ECC – czym różni się od zwykłego RAM-u i gdzie jest potrzebna?
Pamięć ECC (Error-Correcting Code) to wysoce wyspecjalizowany rodzaj pamięci operacyjnej, zaprojektowany do automatycznego wykrywania i naprawiania błędów danych w locie. W mojej codziennej, audytorskiej praktyce w IT Magazyn często spotykam się z inżynierami, którzy traktują dobór pamięci RAM wyłącznie przez pryzmat taktowania i opóźnień. Tymczasem w środowiskach krytycznych to właśnie brak mechanizmów korekcji błędów bywa najsłabszym ogniwem infrastruktury. Dlaczego tak się dzieje i czy zaawansowane moduły serwerowe są nam faktycznie potrzebne?
Czym fizycznie różni się pamięć ECC od zwykłego RAM-u?
Zwykła pamięć RAM (Non-ECC) dba wyłącznie o szybkość przesyłu danych, całkowicie ignorując spójność informacji. Jeśli w trakcie pracy komputera dojdzie do zmiany stanu fizycznego komórki pamięci (tzw. bit flip – losowa zmiana z 0 na 1 lub odwrotnie), system operacyjny i procesor nie mają o tym pojęcia. Konsekwencją jest zazwyczaj zawieszenie aplikacji, ekran Blue Screen (BSOD) lub, co najgorsze, niewykryte uszkodzenie pliku zapisywanego na dysku.
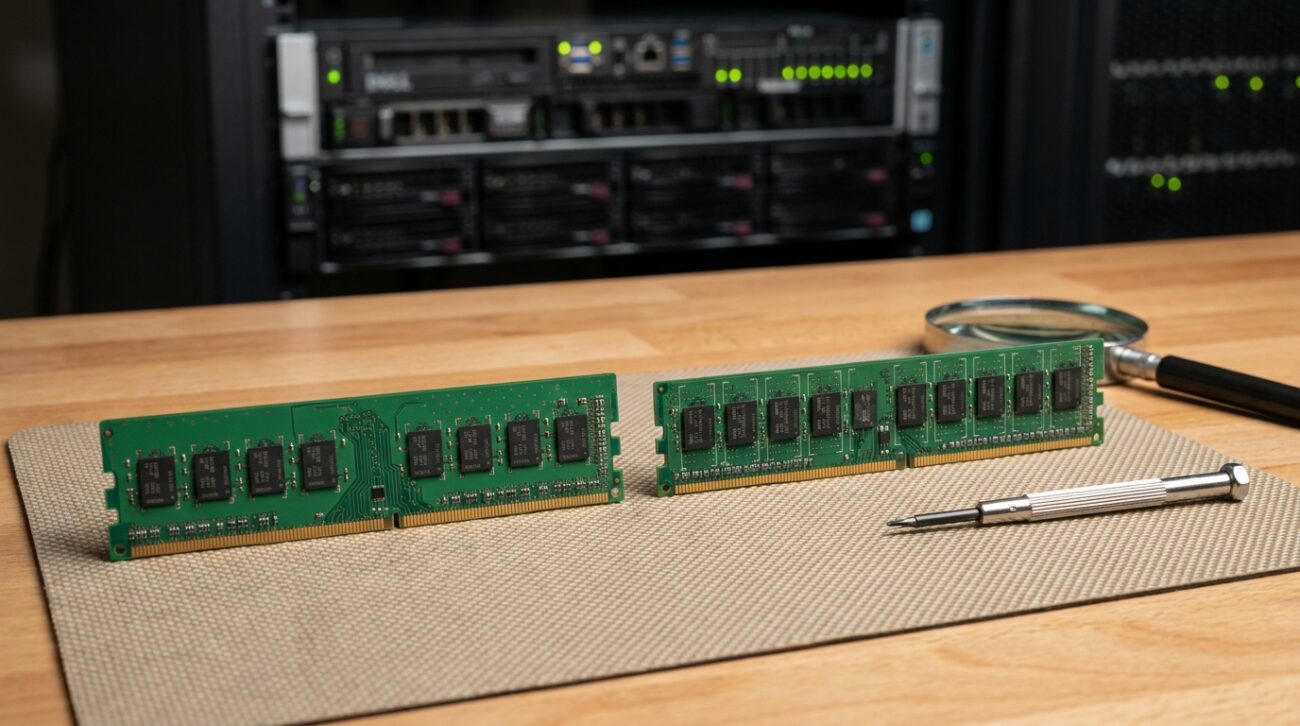
Zastosowanie pamięci ECC całkowicie eliminuje to ryzyko dzięki sprzętowej nadmiarowości. Różnice te widać już na poziomie fizycznego laminatu modułu DIMM:
- Fizyczna budowa i dodatkowy układ: Standardowy moduł RAM posiada zazwyczaj 8 układów pamięci na jednej stronie laminatu. Moduł ECC dysponuje 9 układami. Ten dodatkowy chip jest dedykowany do przechowywania matematycznego kodu korekcyjnego (parzystości).
- Szerokość szyny danych: Standardowa szyna RAM w modułach od DDR2 do DDR4 ma szerokość 64 bitów. Pamięci ECC wykorzystują szynę o szerokości 72 bitów. Te dodatkowe 8 bitów służy do przesyłania sum kontrolnych bezpośrednio do procesora.
- Kompatybilność sprzętowa: Moduły z pełną korekcją błędów wymagają dedykowanego procesora (np. Intel Xeon, AMD EPYC, Threadripper) oraz odpowiedniego chipsetu. Przeciętna płyta główna gamingowa nie uruchomi się po zainstalowaniu profesjonalnych kości RDIMM, co potwierdzają specyfikacje konsumenckie [Źródło 1].
Sercem technologii ECC jest algorytm SEC-DED (Single Error Correction – Double Error Detection), najczęściej oparty na rozszerzonych kodach Hamminga [Źródło 2]. Jednobitowe błędy (SBE) są automatycznie wykrywane i naprawiane w ułamku sekundy, bez jakiegokolwiek przerywania pracy systemu. Z kolei błędy dwubitowe (DBE), choć nienaprawialne, są natychmiast wykrywane. W takiej sytuacji serwer bezpiecznie wstrzymuje proces (kernel panic), zapobiegając utrwaleniu uszkodzonych danych na nośnikach trwałych.
DDR5 On-Die ECC a Side-Band ECC: Dlaczego nowy standard to pułapka?
Moduły pamięci DDR5 posiadają wbudowany mechanizm On-Die ECC, jednak nie jest to rozwiązanie tożsame z pełną, serwerową korekcją błędów. W branży utarł się niebezpieczny mit, mówiący o tym, że skoro każdy DDR5 ma „wbudowane ECC”, nie potrzebujemy już drogich pamięci serwerowych. Jest to fundamentalne niezrozumienie najnowszych standardów JEDEC.
Jak szczegółowo tłumaczą specjaliści z branży przemysłowej [Źródło 3], komórki pamięci w architekturze DDR5 stały się tak mikroskopijne i gęsto upakowane, że są naturalnie podatne na błędy wewnętrzne wynikające z fluktuacji napięć. Dlatego wprowadzono On-Die ECC. Jego rola polega na naprawianiu błędów wyłącznie wewnątrz samej kości krzemu, zanim dane trafią na szynę.
Jednak On-Die ECC nie chroni danych „w tranzycie” (in transit) przez płytę główną do procesora, ani nie raportuje zaistniałych błędów do systemu operacyjnego. Do zapewnienia prawdziwej, serwerowej odporności nadal wymagany jest Side-Band ECC (Full ECC). W przypadku DDR5 architektura dzieli się na dwa niezależne sub-kanały. Pamięć Non-ECC dysponuje szyną 2×32 bity, podczas gdy prawdziwe, serwerowe kości DDR5 ECC używają poszerzonej szyny 2×40 bitów, aby zagwarantować bezkompromisowe bezpieczeństwo.
Ciche uszkodzenia danych: Skąd biorą się błędy w pamięci RAM?
Główną przyczyną występowania błędów w pamięci RAM są tzw. błędy miękkie (Soft Errors) wywoływane przez promieniowanie kosmiczne oraz starzenie się układów scalonych (Hard Errors). Zjawisko Single Event Upsets (SEU) ma miejsce, gdy wtórne neutrony uderzają w krzem na poziomie morza, zmieniając stan naładowania kondensatora i indukując bit flip.
W skali mikro wydaje się to mało prawdopodobne, jednak w makroskali centrów danych problem staje się krytyczny. Przełomowe i wielkoskalowe badanie przeprowadzone przez Google w 2009 roku („DRAM Errors in the Wild”) na milionach serwerów, rzuciło nowe światło na awaryjność pamięci [Źródło 4]. Raport wykazał szokujące statystyki:
- Średni wskaźnik błędów wynosi od 2 000 do 6 000 poprawialnych błędów (SBE) na 1 GB RAM rocznie.
- Aż 8% wszystkich używanych na świecie modułów DIMM w ujęciu rocznym wykazuje co najmniej jeden twardy błąd.
- Niemal jedna trzecia (33%) wszystkich maszyn w dużych farmach obliczeniowych doświadcza minimum jednego błędu pamięci na rok.
Zauważyłam, że najczęstszym błędem analityków jest lekceważenie tego zjawiska u zwykłych użytkowników. Tymczasem dane telemetryczne pochodzące od deweloperów przeglądarki Mozilla Firefox udowadniają, że około 10% wszystkich zgłaszanych awarii aplikacji na komputerach PC nie wynika z wadliwego kodu, lecz właśnie z losowych przekłamań w pamięci operacyjnej pozbawionej ECC [Źródło 5].
Gdzie pamięć ECC jest absolutnie niezbędna?
Inwestycja w infrastrukturę opartą na pamięci z korekcją błędów jest kategorycznie wymagana w środowiskach, gdzie integralność danych wyznacza ramy bezpieczeństwa biznesowego.
1. Systemy plików oparte na sumach kontrolnych (ZFS, Btrfs)
Nowoczesne systemy plików z zaawansowanym buforowaniem, takie jak ZFS wykorzystywany w systemach TrueNAS czy serwerach opartych o FreeBSD [Źródło 6], w pełni polegają na pamięci RAM do wyliczania sum kontrolnych przed fizycznym zapisem na dysk. Błąd bitowy w buforze spowoduje, że system wyliczy nową, „poprawną” sumę kontrolną dla uszkodzonych danych. Cicha korupcja stanie się wtedy permanentna, bez szansy na odtworzenie pliku.
2. Bazy danych SQL, systemy ERP i serwery wirtualizacji
W sektorze finansowym (np. w bankowości) lub medycznym zmiana jednego bitu (np. wartości numerycznej w systemie księgowym lub przypisanego ID pacjenta) wywołuje katastrofalne straty. Każdy wirtualizator bazujący na hipernadzorcach potrzebuje ECC do izolowania awarii między maszynami wirtualnymi.
3. Lotnictwo i sektor kosmiczny
Wraz ze wzrostem wysokości (np. w kabinie pasażerskiej samolotu) natężenie promieniowania jonizującego diametralnie rośnie, ponieważ brakuje grubej warstwy atmosfery pochłaniającej neutrony. Sprzęt awioniczny jest ekstremalnie narażony na zjawisko SEU, a implementacja ECC to podstawa certyfikacji bezpieczeństwa urządzeń latających.
Czego nie dowiesz się ze standardowych poradników: Patrol Scrubbing i Chipkill
Eksperckie wykorzystanie pamięci RAM w środowiskach cloudowych opiera się na ukrytych procesach, z których zwykły konsument nie zdaje sobie sprawy.
Większość administratorów traktuje ECC jako mechanizm reaktywny. W zaawansowanych systemach serwerowych wdraża się tzw. Patrol Scrubbing [Źródło 7]. To proaktywny, działający w tle proces sprzętowy. Kontroler pamięci rutynowo „przeczesuje” cały adresowany obszar RAM-u w poszukiwaniu błędów jednobitowych. Naprawia je prewencyjnie, zanim ulegną nagromadzeniu i przekształcą się w krytyczny błąd dwubitowy (DBE), powodując awarię jądra systemu.
Kolejną mało znaną warstwą ochrony jest Chipkill ECC – autorska architektura zapoczątkowana przez firmę IBM. Tradycyjny ECC SEC-DED nie radzi sobie z całkowitym przepaleniem lub fizycznym zniszczeniem całego czarnego chipu DRAM na module. Technologia Chipkill potrafi na bieżąco rekonstruować utracone dane z kompletnie martwego, wielobitowego klastra ułożonego w jednym układzie scalonym. Chroni to również serwery przed nowoczesnymi atakami sprzętowymi typu Rowhammer, polegającymi na generowaniu zakłóceń elektromagnetycznych poprzez błyskawiczne odpytywanie sąsiadujących rzędów komórek pamięci.
Zwykły RAM a pamięć serwerowa ECC – Zestawienie różnic technicznych
Poniższa tabela szczegółowo porównuje najpopularniejsze warianty modułów spotykane w dzisiejszych stacjach roboczych i serwerowniach:
Czytaj więcejZwiń
| Cecha techniczna | Non-ECC (Konsumencka) | ECC UDIMM (Niebuforowana) | ECC RDIMM (Rejestrowana) |
|---|---|---|---|
| Szerokość szyny danych (DDR4) | 64 bity | 72 bity | 72 bity |
| Korekcja błędów SEC-DED | Brak | Tak (Zgłaszanie do CPU) | Tak (Zaawansowana) |
| Układ odciążający (Rejestr) | Brak | Brak | Tak (Wbudowany bufor PLL) |
| Zastosowanie docelowe | Gaming, biuro, laptopy domowe | Stacje robocze, podstawowe serwery NAS | Data Center, zaawansowana wirtualizacja, klastry AI |
| Skalowalność (Max RAM na płytę) | Ograniczona (np. 128 GB) | Ograniczona (np. 128 GB) | Ekstremalna (wiele Terabajtów na serwer) |
Podsumowanie eksperckie
Moduły pamięci RAM wyposażone w układ ECC są absolutnym fundamentem bezpieczeństwa w architekturze IT. Podczas gdy układy konsumenckie stawiają na wyśrubowane taktowanie przy zachowaniu niskiej ceny, rozwiązania serwerowe traktują jako priorytet nieskazitelną stabilność systemu i ochronę baz danych przed cichą korupcją. Decydując się na uruchomienie krytycznych usług lub zaawansowanych macierzy dyskowych w domu czy w firmie, oszczędność na kosztach modułów ECC bywa decyzją, która mści się utratą najważniejszych zasobów w najmniej oczekiwanym momencie.
Bibliografia i źródła
- [Źródło 1] Płyty główne – specyfikacje techniczne i kompatybilność modułów (mediaexpert.pl)
- [Źródło 2] Architektura pamięci, kody Hamminga i technologia Chipkill (wikipedia.org)
- [Źródło 3] DDR5 ECC Explained: On-Die ECC vs Side-Band ECC (atpinc.com)
- [Źródło 4] DRAM Errors in the Wild: A Large-Scale Field Study, Bianca Schroeder et al. (researchgate.net)
- [Źródło 5] Analiza awaryjności przeglądarek w systemach Windows – Telemetria (developers.com)
- [Źródło 6] ZFS Best Practices Guide – Memory requirements (freebsd.org)
- [Źródło 7] Server ECC Memory: Stop Silent Data Corruption & Patrol Scrubbing (servermall.com)
FAQ – najczęściej zadawane pytania
Czym jest pamięć ECC i jaka jest jej główna funkcja?
Pamięć ECC (Error-Correcting Code) to wyspecjalizowany rodzaj pamięci RAM, który potrafi automatycznie wykrywać i naprawiać błędy danych. Dzięki algorytmowi SEC-DED naprawia błędy jednobitowe w locie i wykrywa błędy dwubitowe, co zapobiega zawieszaniu się systemów i uszkodzeniom plików.
Jak fizycznie rozpoznać moduł pamięci ECC?
Moduły ECC różnią się od standardowego RAM-u budową fizyczną: posiadają zazwyczaj dziewięć układów pamięci zamiast ośmiu oraz szerszą, 72-bitową szynę danych (zwykły RAM ma 64 bity). Dodatkowy chip i bity służą do przechowywania oraz przesyłania kodów korekcyjnych.
Czy On-Die ECC w kościach DDR5 to to samo co pełne ECC?
Nie, On-Die ECC w standardzie DDR5 naprawia błędy tylko wewnątrz samej kości krzemu i nie chroni danych podczas przesyłu przez płytę główną do procesora. Pełną ochronę serwerową zapewnia dopiero Side-Band ECC (Full ECC), który raportuje błędy do systemu operacyjnego.
Co powoduje błędy w pamięci RAM i jak często one występują?
Błędy wywoływane są głównie przez promieniowanie kosmiczne (uderzenia neutronów zmieniające stan bitu) oraz starzenie się komponentów. Badania wykazują, że nawet jedna trzecia serwerów w dużych centrach danych może doświadczyć co najmniej jednego błędu pamięci rocznie.
W jakich zastosowaniach pamięć ECC jest niezbędna?
ECC jest krytyczna w systemach plików opartych na sumach kontrolnych (ZFS, Btrfs), bazach danych SQL, systemach ERP, sektorze finansowym, medycznym oraz w lotnictwie i technologiach kosmicznych, gdzie integralność danych jest priorytetem.
Czym są technologie Patrol Scrubbing i Chipkill?
Patrol Scrubbing to proaktywne przeszukiwanie RAM-u w celu naprawy błędów zanim się skumulują, natomiast Chipkill to zaawansowany mechanizm pozwalający na stabilną pracę serwera nawet w przypadku fizycznego uszkodzenia całego układu scalonego na module pamięci.


