Data warehouse, data lake czy lakehouse – czym się różnią?
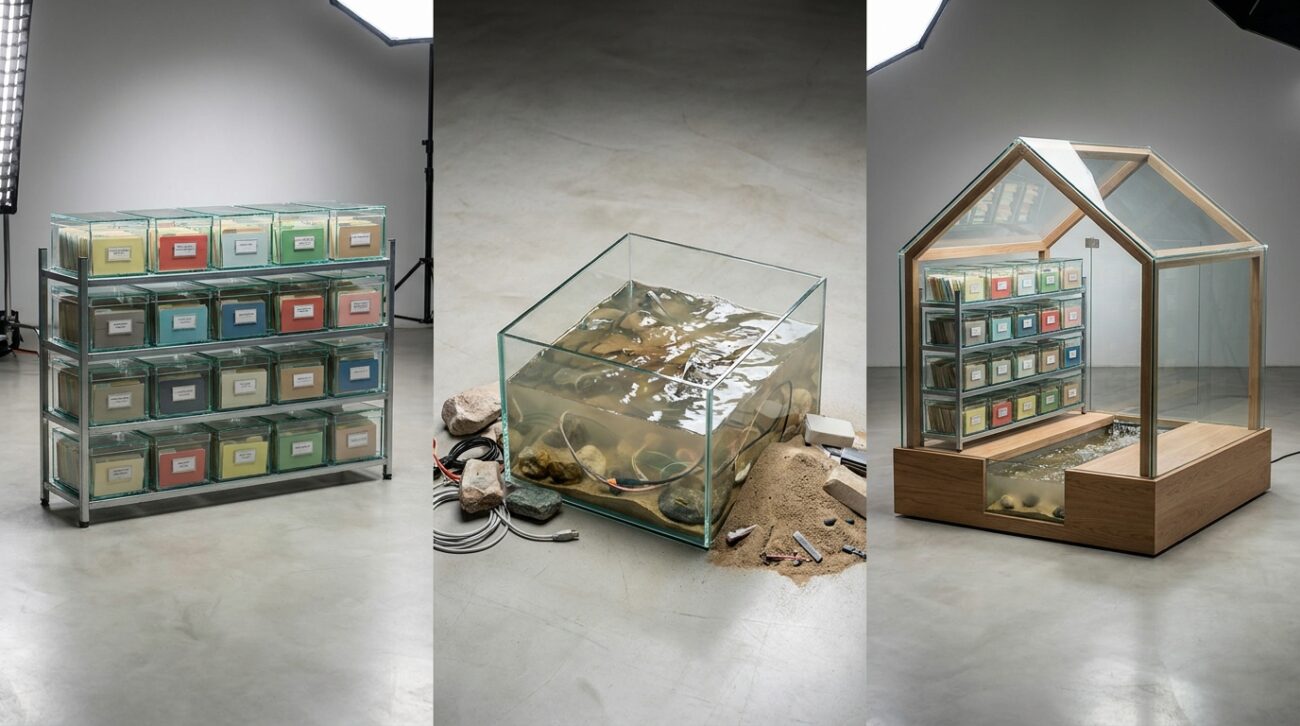
Wybór między hurtownią danych, jeziorem danych a nowoczesną architekturą lakehouse determinuje dziś rynkowe przetrwanie zaawansowanych projektów AI w przedsiębiorstwach. Zrozumienie fundamentalnych różnic w sposobie zapisu, strukturze metadanych oraz celach biznesowych tych trzech podejść pozwala uniknąć katastrofalnych w skutkach i kosztownych błędów architektonicznych. Czym zatem dokładnie różnią się technologie data warehouse, data lake oraz najnowszy standard, jakim jest data lakehouse?
Data Warehouse (Hurtownia danych) – dlaczego porządek i SQL to czasem za mało?
Hurtownia danych opiera się na rygorystycznej architekturze Schema-on-Write (schemat przy zapisie), gwarantując pełną spójność ACID i błyskawiczne zapytania SQL. Zanim jakiekolwiek informacje trafią do bazy, muszą zostać starannie ustrukturyzowane, wyczyszczone i przepuszczone przez złożone potoki ETL (Extract, Transform, Load). To środowisko dedykowane wyłącznie danym tabelarycznym.
Główne zastosowanie hurtowni to klasyczne Business Intelligence (BI), sztywne raportowanie finansowe oraz generowanie statycznych pulpitów menedżerskich. Choć zapewniają one doskonałą wydajność dla zapytań o z góry znanej strukturze, ich największą wadą jest brak elastyczności. Jak zauważają analitycy w raporcie [Źródło 1], masowe przejście z systemów legacy EDW (Enterprise Data Warehouse) jest obecnie koniecznością dla firm, które chcą poważnie myśleć o wdrażaniu generatywnej sztucznej inteligencji. Tradycyjna hurtownia generuje po prostu zbyt wysokie koszty skalowania przestrzeni dyskowej i nie radzi sobie z plikami multimedialnymi czy surowymi logami.
Data Lake (Jezioro danych) – tania przestrzeń czy ryzyko bagna danych?
Jezioro danych to całkowite przeciwieństwo hurtowni: wykorzystuje podejście Schema-on-Read, co pozwala zrzucać surowe dane bezpośrednio na tanią pamięć obiektową. Środowiska chmurowe, takie jak AWS S3 czy Azure ADLS, przyjmują każdy format. Od danych ustrukturyzowanych, przez półstrukturyzowane (JSON, XML), aż po całkowicie nieustrukturyzowane zbiory (pliki audio, wideo, surowe dokumenty PDF, logi serwerowe).
Jeziora danych stały się technologicznym fundamentem dla zespołów Data Science, służąc do swobodnej eksploracji oraz trenowania modeli uczenia maszynowego (ML). Mimo ogromnego wzrostu popularności, przed którym ostrzegają jednak eksperci, głównym problemem tego rozwiązania jest tzw. zjawisko Data Swamp (bagno danych). Brak kontroli jakości, wersji czy narzuconej spójności sprawia, że po kilku latach nikt w organizacji nie wie, jak skutecznie odpytać zebrane zbiory. Niemniej jednak, potencjał inwestycyjny tej technologii wciąż jest gigantyczny. Zgodnie z analizą [Źródło 2], rynek rozwiązań Data Lake osiągnął w 2025 roku pułap 11,07 miliarda USD i prognozuje się, że wzrośnie do ponad 84 miliardów USD przed końcem 2034 roku.
Data Lakehouse – jak hybryda łączy najlepsze cechy obu światów?
Architektura Data Lakehouse to nowoczesna hybryda nakładająca inteligentną, relacyjną warstwę metadanych i transakcyjności na tanie, chmurowe dyski obiektowe. System ten eliminuje konieczność utrzymywania dwóch odseparowanych środowisk (jeziora i hurtowni), definitywnie kończąc z problemem ciągłego kopiowania i synchronizowania tych samych rekordów bazodanowych.
To podejście umożliwia obsługę pełnego spektrum plików (ustrukturyzowanych i nieustrukturyzowanych) w ramach zintegrowanej platformy. Ten sam zbiór fizyczny obsługuje analityków biznesowych piszących standardowy SQL oraz inżynierów MLOps tworzących zaawansowane modele. Według prognoz [Źródło 3], silniki typu „lakehouse-centric” wyznaczają dziś główny kierunek rozwoju dla całego rynku zarządzania oprogramowaniem analitycznym.
Czytaj więcejZwiń
| Cecha Architektury | Data Warehouse | Data Lake | Data Lakehouse |
|---|---|---|---|
| Sposób zapisu | Schema-on-Write (ścisły schemat) | Schema-on-Read (brak schematu) | Elastyczny schemat z transakcjami ACID |
| Typy obsługiwanych danych | Wyłącznie tabelaryczne | Wszystkie formaty (w tym audio/wideo) | Wszystkie formaty (wsparcie AI/ML) |
| Koszty Storage’u | Bardzo wysokie | Bardzo niskie (Object Storage) | Niskie (Object Storage z metadanymi) |
| Odbiorca docelowy | Analitycy Biznesowi (BI) | Data Scientists (Eksploracja) | Zespoły Cross-funkcjonalne (BI + ML) |
Czego nie dowiesz się ze standardowych poradników – ukryte wyzwania architektury hybrydowej
Optymalizacja nowoczesnych platform z danymi wykracza daleko poza same definicje hurtowni czy jeziora. W praktyce rynkowej o sukcesie decydują ukryte warstwy oprogramowania, innowacyjne metody zarządzania cyklem życia pliku oraz precyzyjne mechanizmy kontroli dostępu w środowiskach sfederowanych.
DuckLake – minimalistyczna rewolucja dla średnich zbiorów danych
Architektura DuckLake to odpowiedź na absurdalnie wysokie koszty instancji obliczeniowych gigantów chmurowych przy średniej wielkości projektach. Model ten zakłada połączenie przestrzeni dyskowej z bezserwerowym, wbudowanym silnikiem DuckDB (lub jego chmurową wersją MotherDuck). Zamiast uruchamiać ciężkie klastry obliczeniowe (compute), zapytania analityczne wykonywane są w ułamku sekundy metodą wektorową. Jak wykazują publikacje inżynieryjne [Źródło 4], podejście to drastycznie obniża rachunki w firmach, które nie operują jeszcze na petabajtach, lecz mieszczą się w terabajtowej skali.
Open Table Formats i transakcje ACID na plikach obiektowych
Fundamentem rewolucji Lakehouse są otwarte formaty tabel (Open Table Formats), w szczególności Apache Iceberg, Delta Lake oraz Apache Hudi. To właśnie one pozwalają traktować luźne zbiory plików Parquet zrzucone na AWS S3 czy Azure Blob jak klasyczne tabele. Zapewniają bezbłędną izolację równoczesnych procesów odczytu i zapisu (tzw. ACID na Object Storage), co eliminuje ryzyko korupcji plików. Ciekawą właściwością tych systemów – szeroko omawianą w specyfikacji [Źródło 5] – jest funkcja Time Travel (Podróż w czasie). Umożliwia ona audytorom i deweloperom wywołanie dokładnego stanu tabeli z konkretnego punktu w przeszłości, co jest kluczowe w debugowaniu modeli uczenia maszynowego.
Ewolucja schematu a twarde wymuszanie (Schema Enforcement)
Najlepszą barierą chroniącą przed degradacją jeziora w „Data Swamp” są sprzężone mechanizmy Schema Enforcement oraz Schema Evolution. W hurtowni danych schemat był nienaruszalny. W Data Lakehouse funkcja Enforcement działa jak strażnik – automatycznie odrzuca na etapie zapisu każdy rekord z uszkodzonym typem danych, zgłaszając natychmiastowy błąd potoku. Jednocześnie mechanizm Evolution pozwala na celową, w pełni bezpieczną modyfikację struktury (np. ewolucyjne dodanie nowych kolumn lub zmianę typu z INTEGER na BIGINT), bez wymuszania paraliżującej dla biznesu przebudowy całej gigantycznej bazy [Źródło 6].
Prognozy rynkowe i twarde statystyki wdrożeniowe
Liczby stojące za ekosystemem danych są imponujące i potwierdzają masowy odpływ kapitału z monolitycznych hurtowni danych na rzecz rozwiązań otwartych. Sukces architektury jeziora i lakehouse napędzany jest bezpośrednio przez globalny boom na usługi sztucznej inteligencji.
- Globalny rynek rozwiązań Data Lakehouse osiągnął wartość 10,33 miliarda USD na początku 2025 roku i urośnie do 27,28 miliarda USD w perspektywie 2030 r., osiągając współczynnik CAGR na poziomie 21,4% [Źródło 7].
- Bardziej agresywne modele prognostyczne analizują kwoty rzędu 14 miliardów USD obecnie z docelowym wystrzałem do aż 112,6 miliarda USD do 2035 roku (przy CAGR 23,2%) [Źródło 8].
- Aż 85% przedsiębiorstw, które już wdrożyły technologię Lakehouse, otwarcie deklaruje drastyczne przyspieszenie tempa wydawania nowoczesnych produktów opartych na danych (Data Products) [Źródło 9].
W mojej codziennej audytorskiej praktyce przy projektowaniu środowisk ML spotykam jeden powtarzający się scenariusz: zarządy inwestują miliony w algorytmy AI, zapominając całkowicie o architekturze danych. Modele to tylko silniki. Jeśli do najnowszego silnika nalejemy brudnego paliwa z niezoptymalizowanego Data Swamp, samochód po prostu nie odpali. Implementacja solidnego Federated Catalog (takiego jak np. Unity Catalog [Źródło 10]), połączona ze scentralizowanym modelem Lakehouse, to obecnie jedyny audytowo skuteczny sposób zapanowania nad uprawnieniami w dużych korporacjach.
Podsumowanie – co ostatecznie wybrać do swojego projektu?
Ostateczny wybór infrastruktury zawsze zależy od głównego zastosowania, skali operacji i kompetencji technicznych zatrudnianego zespołu. Data Warehouse nadal pozostaje świetnym, choć wysoce ograniczonym wyborem dla instytucji finansowych potrzebujących wyłącznie klasycznego raportowania i nieustających audytów księgowych o z góry ustalonej strukturze.
Z kolei surowy Data Lake sprawdzi się w projektach ściśle akademickich oraz tam, gdzie nadrzędnym celem jest składowanie logów i filmów, bez konieczności ich natychmiastowej interpretacji. Data Lakehouse jest jednak zdecydowanym zwycięzcą współczesnej ekonomii IT. Oferuje absolutną wszechstronność dla hybrydowych zespołów, uniezależnia firmę od formatów zamkniętych gigantów technologicznych, optymalizuje rachunki chmurowe i kładzie stabilne tory pod generatywną sztuczną inteligencję. Biorąc pod uwagę rosnącą dojrzałość standardów Iceberg czy Delta, jest to obecnie najrozsądniejsza, strategiczna inwestycja.
Bibliografia i źródła
- [Źródło 1] AI Success Requires Data Lakehouses; Accelerate Your Data Warehouse Transition Now (gartner.com)
- [Źródło 2] Data Lake Global Market Value & Growth (fortunebusinessinsights.com)
- [Źródło 3] Worldwide Data Warehouse and Lakehouse Software Forecast (idc.com)
- [Źródło 4] Technical Engineering Guides – DuckDB vs Cloud (motherduck.com)
- [Źródło 5] Open Table Formats & Time Travel Documentation (apache.org)
- [Źródło 6] Schema Validation in Data Lakehouse (databricks.com)
- [Źródło 7] Data Lakehouse Market Size, Share, and Forecast Outlook (thebusinessresearchcompany.com)
- [Źródło 8] Data Lakehouse Market Research & Projections 2025-2035 (futuremarketinsights.com)
- [Źródło 9] Market Guide for Data Lakehouse Platforms (gartner.com)
- [Źródło 10] Unity Catalog & Federated Security (databricks.com)
FAQ – najczęściej zadawane pytania
Czym charakteryzuje się tradycyjna hurtownia danych (Data Warehouse)?
Hurtownia danych opiera się na architekturze Schema-on-Write, wymagającej ustrukturyzowania danych przed zapisem. Jest idealna do raportowania BI i analiz SQL, ale cechuje się wysokimi kosztami skalowania i brakiem wsparcia dla danych nieustrukturyzowanych.
Jakie jest główne ryzyko związane z korzystaniem z Data Lake?
Głównym zagrożeniem jest zjawisko Data Swamp (bagno danych), wynikające z braku kontroli jakości, wersji i spójności danych, co po czasie może uniemożliwić skuteczne przeszukiwanie zgromadzonych zbiorów.
W jaki sposób Data Lakehouse łączy cechy hurtowni i jeziora danych?
Data Lakehouse nakłada relacyjną warstwę metadanych i transakcyjność ACID na tanią pamięć obiektową. Pozwala to na obsługę wszystkich formatów danych i jednoczesne wsparcie dla analityków BI oraz inżynierów uczenia maszynowego.
Czym są Open Table Formats i jaką funkcję pełnią w nowoczesnej architekturze?
Formaty takie jak Apache Iceberg czy Delta Lake pozwalają traktować pliki w chmurze jak tabele, zapewniając izolację procesów zapisu i odczytu oraz funkcję Time Travel, umożliwiającą wgląd w stan danych z przeszłości.
Co to jest mechanizm Schema Enforcement i dlaczego jest istotny?
Jest to mechanizm automatycznie odrzucający rekordy z błędnym typem danych podczas zapisu. Chroni to platformę Lakehouse przed degradacją jakości danych i zapewnia spójność całego systemu.
Dla kogo przeznaczone jest rozwiązanie typu DuckLake?
DuckLake to minimalistyczna architektura dla średnich zbiorów danych (w skali terabajtów), która dzięki silnikowi DuckDB pozwala drastycznie obniżyć koszty chmurowe w porównaniu do dużych, ciężkich klastrów obliczeniowych.