Apache Kafka – jak działa i kiedy warto go używać?
Apache Kafka to potężna, rozproszona platforma do strumieniowania zdarzeń (event streaming platform), która stała się fundamentem nowoczesnej inżynierii danych i architektury systemów rozproszonych. Obecnie to jedno z najważniejszych narzędzi w arsenale architektów IT. Zamiast traktować wiadomości jako ulotne informacje do jednorazowego odczytu, Kafka przechowuje je w sposób trwały i wysoce skalowalny. Wystarczy wspomnieć, że ponad 80% firm z listy Fortune 100 bazuje na tym rozwiązaniu w celu utrzymania swoich systemów o znaczeniu krytycznym [Źródło 1].
Jak działa Apache Kafka? Kluczowe mechanizmy i architektura
Zrozumienie działania platformy wymaga odrzucenia schematów znanych z tradycyjnych systemów kolejkowych. Apache Kafka opiera się na wysoce wydajnym, niezmiennym zapisie danych. Poniżej omawiam najważniejsze koncepcje, które stanowią o jej architektonicznej unikalności, co potwierdzają obszerne dokumentacje techniczne [Źródło 2].
Dziennik zdarzeń typu Commit Log
Dziennik typu Commit Log stanowi fundamentalny element architektury Kafki. Jest to uporządkowany, sekwencyjny i niezmienny zapis zdarzeń na dysku (append-only). Oznacza to, że raz dodane zdarzenie nie może zostać nadpisane ani w żaden sposób zmodyfikowane. Dzięki temu uzyskuje się bezprecedensową prędkość zapisu oraz absolutną pewność co do kolejności występowania zdarzeń w czasie.
Model Publish-Subscribe: Producenci i Konsumenci
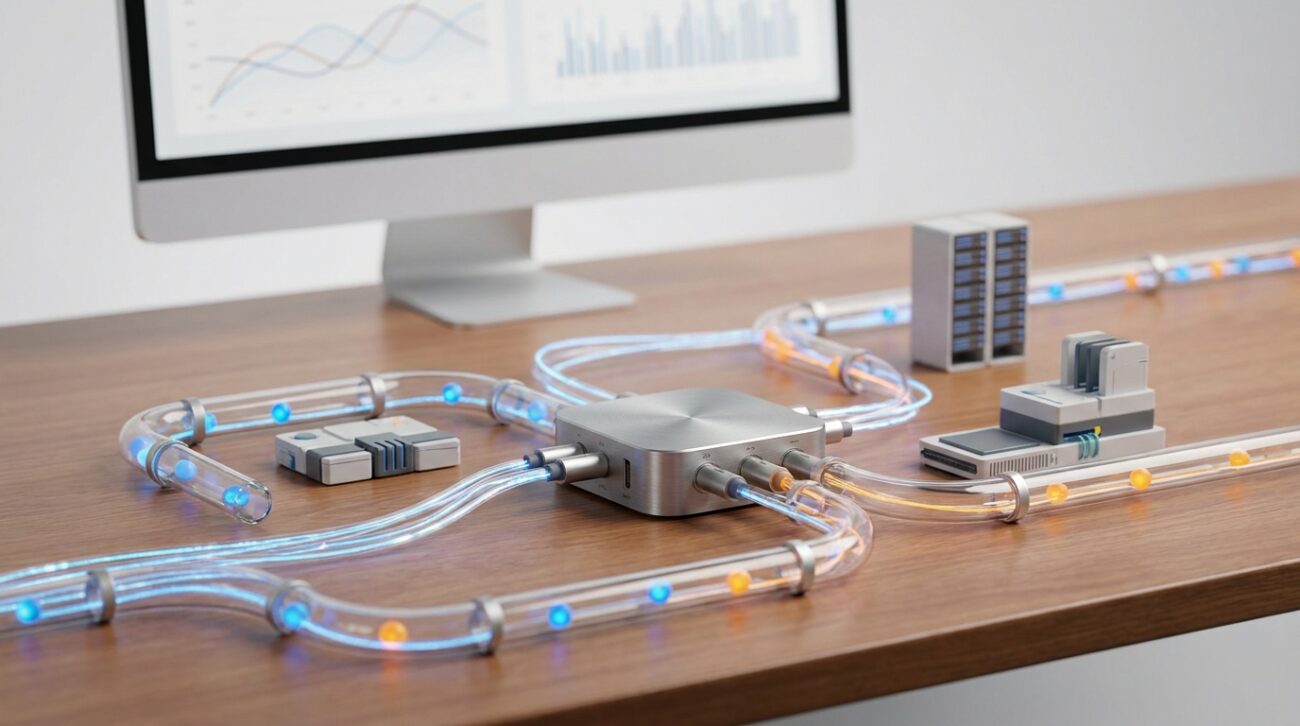
Kafka funkcjonuje w asynchronicznym modelu komunikacji wydawca-subskrybent. Producenci (producers) publikują strumienie danych do logicznych kategorii nazywanych tematami (topics). Następnie, niezależni Konsumenci (consumers) subskrybują wybrane tematy, aby odczytywać i przetwarzać napływające komunikaty. Pełna separacja tych dwóch ról umożliwia tworzenie elastycznych, luźno powiązanych mikroserwisów [Źródło 3].
Partycjonowanie i horyzontalna skalowalność
Horyzontalna skalowalność Kafki wynika bezpośrednio z mechanizmu partycjonowania. Każdy temat (topic) jest dzielony na niezależne partycje (partitions), które są dystrybuowane między wieloma fizycznymi serwerami (brokerami) w klastrze. Pozwala to na jednoczesny zapis i odczyt danych przez dziesiątki lub setki maszyn, co drastycznie zwiększa przepustowość platformy.
Grupy Konsumentów (Consumer Groups)
Grupy konsumentów to zaawansowany mechanizm zapewniający wydajne przetwarzanie równoległe bez ryzyka dublowania pracy. Kafka automatycznie przydziela konkretne partycje do pojedynczych konsumentów wewnątrz grupy. Dzięki temu każdy komunikat z danej partycji jest analizowany przez dokładnie jedną maszynę w grupie, co ułatwia zarządzanie stanem i dystrybucję obciążenia sieciowego [Źródło 4].
Kiedy warto używać Apache Kafka? (Najlepsze zastosowania)
Wybór technologii Apache Kafka jest uzasadniony w scenariuszach wymagających ekstremalnej wydajności, ultra-niskich opóźnień oraz niezawodnego przetwarzania gigantycznych wolumenów danych. Jest to technologia niezastąpiona wszędzie tam, gdzie czas to dosłownie pieniądz.
- Przetwarzanie strumieniowe w czasie rzeczywistym (Real-time Stream Processing): Analiza gigabajtów danych „w locie”. Przykładem są systemy wykrywania oszustw bankowych (fraud detection), generowanie dynamicznych rekomendacji w e-commerce czy wyliczanie stawek przejazdów (jak w aplikacjach typu Uber).
- Architektura sterowana zdarzeniami (Event-Driven Architecture): Tworzenie centralnego kręgosłupa komunikacyjnego dla setek mikroserwisów. Kafka pozwala na całkowite odseparowanie (decoupling) usług, co znacząco ułatwia skalowanie i utrzymanie infrastruktury.
- Potoki danych (Data Pipelines) i synchronizacja: Niezawodny transfer danych między bazami transakcyjnymi (np. PostgreSQL) a hurtowniami danych i jeziorami danych (Data Lakes) z wykorzystaniem gotowego rozwiązania Kafka Connect.
- Agregacja logów i telemetria (Log Aggregation): Zbieranie logów aplikacyjnych oraz fizycznych metryk z tysięcy maszyn rozproszonych na całym świecie w jednym scentralizowanym systemie ułatwiającym szybkie zapytania analityczne.
- Śledzenie aktywności użytkowników (User Activity Tracking): To historycznie pierwszy przypadek użycia, dla którego inżynierowie LinkedIn stworzyli to narzędzie. Platforma błyskawicznie rejestruje każde kliknięcie, wyszukiwanie i odsłonę w czasie zbliżonym do rzeczywistego.
Kiedy UNIKAĆ Apache Kafka?
Pomimo ogromnej mocy obliczeniowej, Apache Kafka nie jest lekiem na całe zło i w wielu przypadkach może stanowić niepotrzebny przerost formy nad treścią. Rozumienie jej ograniczeń jest cechą dojrzałego architekta.
Należy unikać wdrażania Kafki, gdy potrzebny jest prosty system kolejkowy typu „wyślij i zapomnij” dla niewielkiego ruchu. W takich sytuacjach lekki broker, na przykład RabbitMQ, będzie znacznie tańszy i szybszy w konfiguracji [Źródło 3]. Ponadto, utrzymanie klastra Kafki pochłania spore zasoby pamięci operacyjnej (RAM) oraz wymaga dedykowanego zespołu operacyjnego, co wyklucza ją w środowiskach z restrykcyjnymi limitami sprzętowymi. Nie sprawdza się też tam, gdzie potrzebna jest skomplikowana logika routingu oparta na filtrach nagłówków (standard AMQP radzi sobie z tym lepiej).
Czytaj więcejZwiń
| Cecha systemu | Apache Kafka | Standardowy Broker (np. RabbitMQ) |
|---|---|---|
| Sposób zapisu danych | Trwały Commit Log (dysk) | Pamięć (ulotne, usuwane po odczycie) |
| Główny model pracy | Event Streaming / Replay danych | Proste kolejkowanie (Task Queue) |
| Routing i filtrowanie | Bardzo proste (wg. tematów/kluczy) | Zaawansowane (Exchange, Headers) |
| Przepustowość | Miliony zdarzeń / sekundę | Tysiące zdarzeń / sekundę |
Czego nie dowiesz się ze standardowych poradników? Sekrety i zaawansowane encje branżowe
Za powierzchowną warstwą podziału na producentów i konsumentów kryją się zaawansowane mechanizmy decydujące o niezwykłej odporności i szybkości platformy. Warto pochylić się nad koncepcjami, które rzadko pojawiają się w kursach dla początkujących, a są na porządku dziennym u inżynierów DataOps.
Architektura bez ZooKeepera: Era KRaft
Protokół KRaft (Kafka Raft Metadata Mode) zrewolucjonizował architekturę klastra poprzez całkowitą eliminację przestarzałej zależności od systemu Apache ZooKeeper. KRaft to nowożytny, wbudowany mechanizm konsensusu zarządzający metadanymi bezpośrednio wewnątrz brokerów Kafki. Znacząco upraszcza to utrzymanie sieci, zwiększa skalowalność partycji i drastycznie redukuje czasy odzyskiwania sprawności po nieoczekiwanych awariach brokerów [Źródło 2].
Magia optymalizacji systemowej: Zero-copy i funkcja sendfile()
Technologia Zero-copy jest sekretem wydajności przesyłania danych w Kafce. Zamiast odczytywać dane z dysku do przestrzeni użytkownika (aplikacji JVM) i kopiować je z powrotem do buforów gniazd sieciowych, system operacyjny używa wywołania sendfile(). Kafka przekazuje dane z pamięci podręcznej systemu (page cache) bezpośrednio do karty sieciowej. To omijanie środowiska użytkownika minimalizuje zużycie procesora (CPU) niemal do zera i pozwala na saturację łączy wielogigabitowych [Źródło 5].
Gwarancja spójności: ISR i High-Water Mark
Trwałość danych w systemie gwarantuje zbiór ISR (In-Sync Replicas) – są to repliki partycji, które w 100% nadążają z synchronizacją z głównym liderem [Źródło 4]. Dodatkowo ważnym wskaźnikiem jest offset zwany High-Water Mark (HWM). Oznacza on ostatni komunikat skutecznie skopiowany do wszystkich maszyn należących do ISR. Konsumenci mają prawo pobrać dany wpis tylko i wyłącznie wtedy, gdy znajdzie się on poniżej poziomu HWM, co daje żelazną gwarancję spójności danych przy ewentualnym przełączaniu liderów.
Nietypowe usuwanie danych: Log Compaction
Strategia Log Compaction (Kompakcja logów) to unikalny mechanizm utrzymywania cyklu życia zdarzeń. Zamiast bezwzględnie kasować komunikaty po upływie zadanego czasu retencji, Kafka zachowuje w dzienniku tylko najnowszą wartość dla danego klucza, a duplikaty w tle redukuje. Jest to funkcja absolutnie krytyczna w architekturze Event Sourcing, ponieważ umożliwia szybkie odbudowanie ostatecznego stanu bazy danych (np. profilu klienta) z samego dziennika zdarzeń.
W mojej codziennej audytorskiej praktyce przy ocenie klastrów rozproszonych zauważyłam, że najczęstszym i najbardziej kosztownym błędem infrastrukturalnym jest niewłaściwe zarządzanie mechanizmem Consumer Group Rebalancing. Zła konfiguracja sygnałów heartbeat doprowadza do tzw. „rebalancing storms”, w których nowi konsumenci zawieszają odczyt na całe minuty. To uświadamia, że znajomość samej teorii to za mało do utrzymania produkcyjnego klastra.
Statystyki i potężna wartość biznesowa rynku Managed Kafka
Dominacja technologiczna przekłada się na konkretne uwarunkowania biznesowe i potężne przepływy finansowe w sektorze IT. Zgodnie z analityką rynku z 2025 roku, technologia ta stała się de facto korporacyjnym standardem dla platform analitycznych.
Adopcja wśród globalnych gigantów mówi sama za siebie. Jak wskazują analizy IT, ponad 80% firm z listy Fortune 100 polega na narzędziach z ekosystemu Apache [Źródło 1]. W tym Kafka stanowi rdzeń informatyczny dla 10 na 10 największych gigantów produkcyjnych i ubezpieczeniowych, 8 na 10 potęg telekomunikacyjnych i 70% wiodących instytucji bankowych. W badaniach rynkowych aż 88% specjalistów i inżynierów wskazuje tę technologię jako środowisko mission-critical dla swoich przedsiębiorstw.
To nieustanne zapotrzebowanie nakręca ogromny segment dostawców chmurowych. Globalny rynek w pełni zarządzanych usług (Managed Kafka Services) osiągnął pułap wyceny 2,8 miliarda USD w 2025 roku [Źródło 6]. Według prognoz finansowych wykazuje on oszałamiające tempo wzrostu (wskaźnik CAGR na poziomie 15,2%), a do roku 2033 spodziewana wartość sektora wzrośnie aż do 8,4 miliarda USD [Źródło 6]. To oznacza, że popyt na stabilne i bezpieczne wdrażanie tego systemu do streamingu będzie generować gigantyczne koszty i równie potężne zyski w sektorze B2B.
Podsumowanie
Apache Kafka przestała być tylko modnym narzędziem z Doliny Krzemowej i przeistoczyła się w branżowy standard do agregacji logów, komunikacji mikroserwisów i zarządzania gigantycznymi strumieniami danych. Dzięki przemyślanej inżynierii łączącej trwałość Commmit Logów, optymalizacje sprzętowe (Zero-copy) oraz nowoczesne konsensusy (KRaft), narzędzie to jest zdolne przetwarzać biliony zdarzeń w sposób rozproszony, dostarczając je z opóźnieniami mierzonymi w milisekundach. Wybór tego środowiska to doskonała decyzja, jednak należy traktować je z szacunkiem ze względu na dużą krzywą uczenia oraz zapotrzebowanie operacyjne klastra.
Bibliografia i źródła
- [Źródło 1] Badania trendów rynku pracy i analizy zapotrzebowania w organizacjach Fortune 100 (bulldogjob.pl)
- [Źródło 2] Oficjalna dokumentacja projektowa dotycząca konsensusu KRaft i replikacji (apache.org)
- [Źródło 3] Baza wiedzy o architekturze zdarzeniowej i brokerach komunikatów (ibm.com)
- [Źródło 4] Dokumentacja inżynieryjna mechanizmów klastrowych oraz grup konsumentów (confluentio.pl)
- [Źródło 5] Zaawansowane porównanie systemów rozproszonych i sprzętowej optymalizacji transferu (redpanda.com)
- [Źródło 6] Raport analityczny dotyczący rynku Managed Kafka Services na lata 2025-2033 (dataintelo.com)
FAQ – najczęściej zadawane pytania
Co to jest Apache Kafka i do czego służy?
Apache Kafka to rozproszona platforma do strumieniowania zdarzeń, która pozwala na trwałe i skalowalne przechowywanie danych. Jest wykorzystywana jako fundament nowoczesnej inżynierii danych, umożliwiając m.in. analizę strumieniową w czasie rzeczywistym.
Na czym polega mechanizm Commit Log?
Commit Log to uporządkowany i niezmienny zapis zdarzeń na dysku, do którego dane są tylko dopisywane. Gwarantuje to dużą szybkość zapisu oraz pewność co do kolejności występowania zdarzeń.
W jaki sposób Kafka zapewnia skalowalność?
Skalowalność horyzontalna realizowana jest poprzez partycjonowanie tematów. Dane są dzielone na niezależne partycje rozproszone między wieloma brokerami, co pozwala na jednoczesną pracę wielu maszyn.
Kiedy warto zdecydować się na wdrożenie Kafki?
Kafkę warto stosować w systemach wymagających ekstremalnej wydajności, takich jak wykrywanie oszustw bankowych, architektury mikroserwisowe sterowane zdarzeniami, agregacja logów czy śledzenie aktywności użytkowników.
W jakich przypadkach Apache Kafka nie jest zalecanym rozwiązaniem?
Należy jej unikać, gdy potrzebny jest prosty system kolejkowy dla małego ruchu, przy dużych ograniczeniach sprzętowych (pamięć RAM) lub gdy wymagana jest bardzo skomplikowana logika routingu danych.
Czym charakteryzuje się nowoczesna architektura bez ZooKeepera?
Nowoczesna Kafka korzysta z protokołu KRaft, który zastępuje ZooKeepera. Jest to wbudowany mechanizm konsensusu zarządzający metadanymi, co upraszcza utrzymanie klastra i zwiększa jego wydajność.


